Note
Je n’ai pas participé à cette compétition. Ce post décortique la solution gagnante publiée par l’équipe Numina, à partir de leurs propres sources (liens en fin d’article), et ce que j’en retiens pour mes projets.
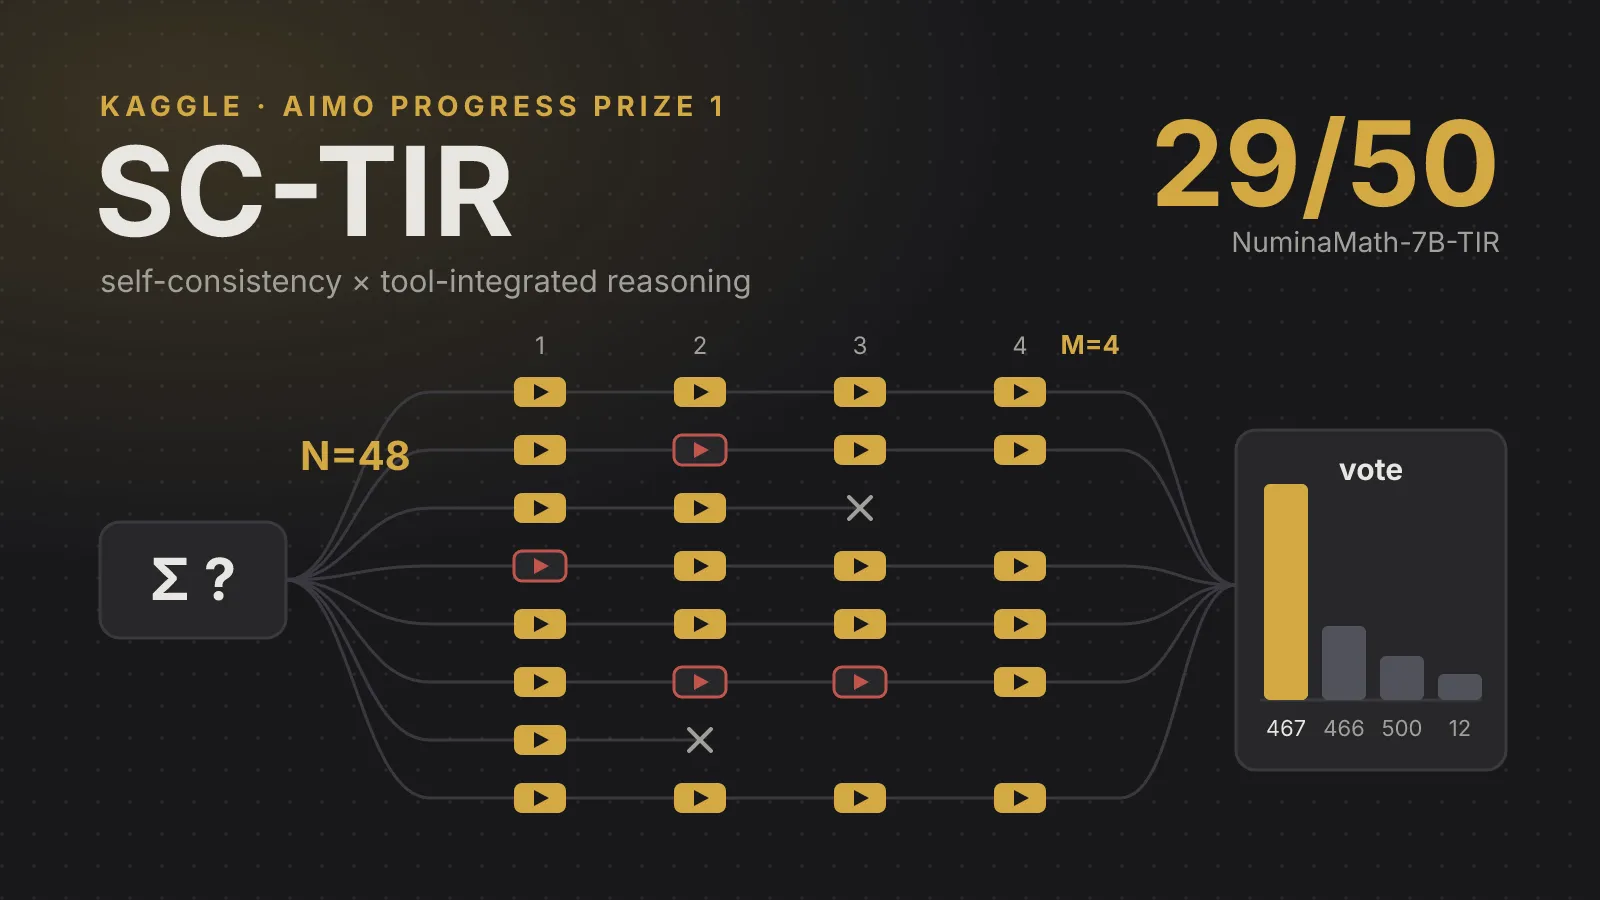
En bref : un modèle de 7 milliards de paramètres, fine-tuné en deux étapes pour raisonner en écrivant et en exécutant du Python, puis interrogé 48 fois en parallèle avec un vote majoritaire. Résultat : 29 problèmes résolus sur 50 sur le leaderboard privé, avec deux GPU T4 et 9 heures de calcul.
1. La compétition en bref
| Critère | Détail |
|---|---|
| Compétition | AI Mathematical Olympiad — Progress Prize 1 (Kaggle) |
| Dates | 1er avril → 27 juin 2024 |
| Participation | 1 161 équipes, 1 831 soumissions, 81 pays |
| Tâche | 50 problèmes de maths par leaderboard (public / privé), niveau AMC12 à AIME, réponse entière |
| Contraintes | 1 GPU P100 ou 2 GPU T4, 9 h max par soumission, 2 soumissions par jour |
| Modèles autorisés | open-weight, publiés avant le 23 février 2024 |
| Gagnant | équipe Numina (avec Hugging Face) — 29/50, 131 072 $ |
La difficulté n’est pas seulement mathématique : il faut tenir 50 problèmes en 9 heures sur du matériel modeste. Chaque choix (taille du modèle, nombre d’échantillons, quantification) se paie en temps de calcul.
2. Le podium : deux recettes comparées
Les deux premières équipes partent du même modèle de base, DeepSeekMath 7B, mais divergent sur la façon de choisir la bonne réponse parmi plusieurs tentatives.
1ʳᵉ place — Numina (29/50)
- Base : DeepSeekMath-Base 7B, fine-tuning complet.
- Données : plusieurs centaines de milliers de problèmes rédigés en Chain of Thought, puis ~60 000 problèmes résolus « avec outils » par GPT-4.
- Inférence : SC-TIR — 48 candidats, 4 tours d’exécution de code, vote majoritaire simple.
- Déploiement : quantification 8 bits (AutoGPTQ) + vLLM.
2ᵉ place — CMU_MATH (22/50)
- Base : DeepSeek-Math-7B-RL, deux modèles fine-tunés.
- Données : 2 600 problèmes (AMC, AIME, Odyssey-Math), 64 solutions par problème générées par GPT-4o et DeepSeek-Coder-V2 → 41 160 solutions correctes.
- Inférence : un modèle de récompense note chaque solution ; vote majoritaire pondéré par ces notes.
- Prix : 65 536 $.
Deux philosophies : Numina mise tout sur un seul modèle très bien entraîné et la loi du nombre ; CMU ajoute un juge (le reward model) pour départager les candidats.
3. Étape 1 — apprendre à raisonner (Chain of Thought)
Le premier fine-tuning apprend au modèle à rédiger une solution pas à pas. Le jeu de données couvre des exercices de lycée jusqu’aux olympiades, et sa construction est un vrai travail de data engineering :
- OCR des PDF d’origine ;
- découpage en paires problème / solution ;
- traduction en anglais ;
- réalignement des solutions au format Chain of Thought ;
- normalisation de la réponse finale.
| Hyperparamètre | Étape 1 (CoT) | Étape 2 (TIR) |
|---|---|---|
| Learning rate | 2.0e-5 | 2.0e-5 |
| Batch total | 32 | 32 |
| Longueur de séquence | 2 048 | 1 024 |
| Époques | 3 | 4 |
| Scheduler | cosine, warmup 0.0 | cosine, warmup 0.1 |
Côté infrastructure : fine-tuning complet (pas de LoRA), gradient
checkpointing, DeepSpeed ZeRO-3 et le SFTTrainer de TRL avec packing.
D’après le dépôt du projet, l’entraînement prend une dizaine d’heures sur un
nœud de 8 × H100.
4. Étape 2 — apprendre à utiliser Python (Tool-Integrated Reasoning)
La deuxième étape change tout : le modèle n’est plus seulement rédacteur, il délègue les calculs à Python. Chaque solution alterne raisonnement, code et sortie d’exécution (format ToRA). Pour la construire, l’équipe a sélectionné ~60 000 problèmes à réponse numérique, fait générer des solutions par GPT-4, trois fois, et n’a gardé que celles qui retombent sur la bonne réponse.
Voici à quoi ressemble ce format, sur un exemple simplifié de mon cru :
Problème : combien d'entiers entre 1 et 1000 sont divisibles par 3 ou par 5 ?

On compte les multiples de 3 et de 5, puis on retire ceux de 15, comptés deux
fois (inclusion-exclusion). Vérifions par le calcul :

```python
print(sum(1 for n in range(1, 1001) if n % 3 == 0 or n % 5 == 0))
```
```output
467
```
La réponse est 467.
Important
L’idée clé : un LLM se trompe souvent en arithmétique, rarement en écrivant le code qui fait l’arithmétique. En confiant les calculs à Python, on supprime toute une classe d’erreurs.
Le gain est net sur le benchmark MATH : 56,3 % pour le modèle CoT seul, environ 68 % pour le modèle TIR.
5. L’inférence : SC-TIR, la vraie arme secrète
À l’inférence, Numina combine auto-cohérence (self-consistency) et exécution de code, sous le nom de SC-TIR :
- dupliquer le problème N = 48 fois pour former un lot de prompts ;
- échantillonner chaque candidat jusqu’à la fin d’un bloc de code Python ;
- exécuter chaque bloc et réinjecter la sortie — y compris les tracebacks, ce qui permet au modèle de se corriger ;
- recommencer M = 4 fois ;
- élaguer les candidats invalides (code incomplet, pas de réponse) ;
- vote majoritaire sur les réponses restantes.
En pseudo-code (simplifié, les fonctions utilitaires sont implicites) :
from collections import Counter

def sc_tir(problem, llm, run_python, n=48, m=4):
    drafts = [make_prompt(problem)] * n          # N copies du même problème
    for _ in range(m):                            # M tours génération + exécution
        drafts = llm.generate(drafts, stop=["```output"])
        for i, text in enumerate(drafts):
            code = last_python_block(text)
            if code and not has_final_answer(text):
                output = run_python(code)         # sortie ou traceback
                drafts[i] = f"{text}```output\n{output}\n```\n"
    answers = [extract_answer(d) for d in drafts]
    answers = [a for a in answers if a is not None]   # élagage
    return Counter(answers).most_common(1)[0][0]      # vote majoritaire
Pour tenir dans le budget, le modèle est quantifié en 8 bits avec AutoGPTQ (calibré sur les données d’entraînement) et servi avec vLLM : les T4 ne gèrent pas le bfloat16 et leur mémoire est limitée.
6. Valider sans sur-apprendre le leaderboard public
Avec seulement 50 problèmes publics, le leaderboard est très bruité. L’équipe s’est donc appuyée sur quatre jeux de validation internes :
| Jeu | Taille | Rôle |
|---|---|---|
| AMC (AMC12 2022-2023) | 83 problèmes | proche du test caché ; ~60-65 % résolus |
| AIME (2022-2024) | 90 problèmes | problèmes durs, modes d’échec |
| MATH niveau 4 | 754 problèmes | volume, réponses entières |
| MATH niveau 5 | 721 problèmes | volume, problèmes les plus durs |
Même avec SC-TIR, le score varie de 1 à 3 % d’une graine aléatoire à l’autre : sans ces jeux, impossible de savoir si une « amélioration » est réelle.
7. Ce qui n’a pas marché (et c’est instructif)
- CoT seul + vote majoritaire : plafonne à 8/50 sur le leaderboard public.
- MMOS (un seul programme Python par solution) : plafonne à 16/50 — un seul tour de code ne suffit pas pour les problèmes difficiles.
- Modèles plus gros (InternLM-20B, CodeLlama-33B, Mixtral-8x7B) : trop lents sur 2 × T4, et DeepSeekMath 7B reste difficile à battre.
- RL (PPO, RLOO) : pas de gain significatif.
- KTO : un peu meilleur (27/50 en public), mais pas eu le temps de l’appliquer au modèle final.
- Fusion de modèles (DARE, TIES, WARP) : régressions.
- Cache KV statique et
torch.compile: erreurs sur les T4 de Kaggle.
8. Ce que j’en retiens pour mes projets
- Les données avant la taille du modèle. Sous contrainte de calcul, un 7B bien entraîné l’a emporté sur des modèles bien plus gros (20B, 33B, Mixtral 8x7B), trop lents pour le budget.
- Laisser l’outil calculer. C’est le principe de mon agent SQL : le LLM écrit la requête, la base calcule. Ici, le LLM écrit le Python, l’interpréteur calcule.
- Le budget d’inférence est un hyperparamètre. N × M règle le compromis entre précision et temps : il se mesure, il ne se devine pas.
- Valider en interne, pas sur le leaderboard public. Des jeux qui imitent le test caché, et plusieurs graines.
- Fine-tuning complet ou LoRA ? Numina a pu se payer un fine-tuning complet sur 8 × H100. Avec moins de calcul, LoRA / QLoRA avec Unsloth, comme dans mon projet Qwen2.5-Coder, reste la voie pragmatique.
9. Pour aller plus loin
- Code (entraînement + notebook Kaggle) : https://github.com/project-numina/aimo-progress-prize
- Modèle : https://huggingface.co/AI-MO/NuminaMath-7B-TIR
- Données : NuminaMath-CoT (~860k problèmes) et NuminaMath-TIR (~70k problèmes)
Sources
- Hugging Face — How NuminaMath Won the 1st AIMO Progress Prize (juillet 2024)
- AIMO — Progress Prize: July 2024 Results
- PR Newswire — First AI Mathematical Olympiad Progress Prize Won By Team Numina
- AIhub — CMU-MATH team’s innovative approach secures 2nd place at the AIMO prize
- Fiche du modèle — AI-MO/NuminaMath-7B-TIR